プロンプトキャッシュで API の入力料金と待ち時間を下げる方法
Claude API の書き方、外れる原因、OpenAI・Gemini との違い
毎回同じ前置きを送る API 利用では、プロンプトキャッシュで入力料金と待ち時間を抑えられます。この記事では、Claude API の指定方法、料金の考え方、効く設計と外れる原因、使用量の確認方法を公式ドキュメントに沿ってまとめ、OpenAI と Gemini の違いも簡潔に整理します。
何が起きているか
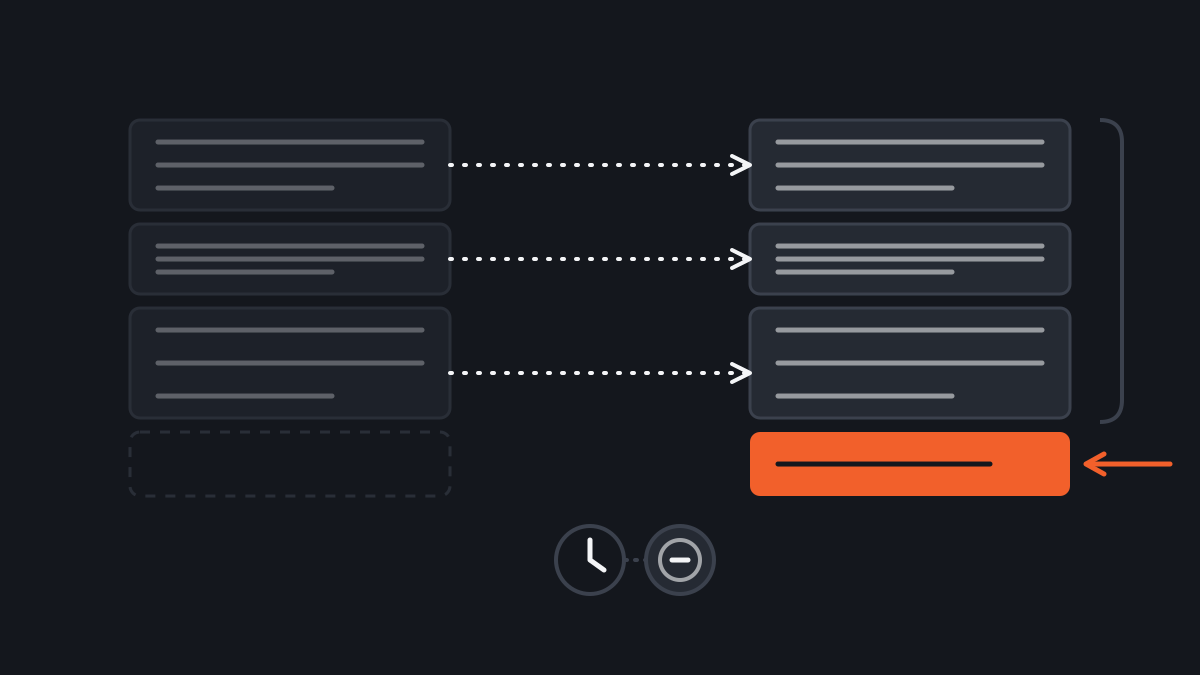
API でチャットボットやエージェントを作ると、毎回のリクエストに同じ内容が繰り返し入ります。システムプロンプト、ツール定義、参考資料、これまでの会話履歴です。会話が長くなるほど、新しい一文のために同じ前置きを毎回送り直し、その分の入力料金を毎回払うことになります。
プロンプトキャッシュは、この繰り返し部分を再利用する仕組みです。再利用された部分は、通常の入力より安い料金で処理されます。待ち時間の短縮も期待できますが、秒数は公式で確認できなかったため、この記事では料金と仕様に絞ります。
主に Claude API を扱い、後半で OpenAI と Google との違いに触れます。数値と仕様は、2026年11月10日に各社の公式ドキュメントで確認した内容です。
仕組み:前置きの一致で決まる
Claude API のキャッシュは「プロンプトの先頭から、指定した位置までが完全に一致するか」で効きます。プロンプトは tools、system、messages の順に並んでいるとみなされ、その先頭から cache_control を付けたブロックまでが、キャッシュの対象です。
公式ドキュメントによると、ヒットには「指定位置までのテキストや画像がすべて同一」であることが必要です。1文字違えば、そこから後ろは別物です。
押さえておく点は次のとおりです。
- 指定方法は2通りあります。リクエストの最上位に
cache_controlを置く「自動キャッシュ」と、内容ブロックに個別に付ける「明示的なブレークポイント」です。 - ブレークポイントは最大4つです。自動キャッシュを併用すると、そのうち1つを使います。
- キャッシュが書き込まれるのは、ブレークポイントの位置だけです。
- 最小トークン数に満たない場合は、エラーにならず、キャッシュされないまま処理されます。
- キャッシュは組織ごと(Claude API ではワークスペースごと)に分離されます。
料金と有効時間の考え方
有効時間(TTL)は2種類あります。
| 種類 | 指定 | 書き込み料金(基本入力料金に対する倍率) |
|---|---|---|
| 5分(既定) | {"type": "ephemeral"} |
1.25倍 |
| 1時間 | {"type": "ephemeral", "ttl": "1h"} |
2倍 |
読み取り(ヒット)は、基本入力料金の0.1倍が標準です。公式の料金表では、Opus 5.5 と Sonnet 5.5 は0.05倍、Fable 5.1 と Mythos 5.1 は0.025倍と、モデルによって異なります。ブレークポイントを置くこと自体に追加料金はありません。
5分の TTL は、使うたびに追加料金なしで延長されます。起点は応答の終了時ではなく、書き込みまたは読み取りのリクエストの開始時点です。5分以内に次のリクエストが続く用途なら5分で足ります。間隔が空く用途では1時間を検討します。
計算例
公式ドキュメントの料金表にある Claude Sonnet 5.5 では、基本入力が100万トークンあたり2ドル、5分の書き込みが2.50ドル、読み取りが0.10ドルです。2万トークンの固定部分を送る場合は、次のようになります。
| 場合 | 固定部分の料金(1回あたり) |
|---|---|
| キャッシュなし | 約0.04ドル |
| 初回(5分で書き込み) | 約0.05ドル |
| 2回目以降(ヒット) | 約0.002ドル |
この料金表の場合、書き込みの割増分は1回のヒットで取り戻せます。数値は表から計算した目安で、出力トークンの料金は別にかかります。
Claude API での書き方
システムプロンプトの末尾のブロックに cache_control を付けるのが基本形です。以下は、公式ドキュメントのコード例と同じ構造を Python で書いたものです。
import anthropic

client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=1024,
    system=[
        {
            "type": "text",
            "text": "...長いシステムプロンプトや参考資料...",
            "cache_control": {"type": "ephemeral"},
        }
    ],
    messages=[{"role": "user", "content": "質問の文章"}],
)
print(response.usage)
会話が伸びるチャットでは、リクエストの最上位に "cache_control": {"type": "ephemeral"} を置く自動キャッシュが使えます。公式ドキュメントでは、ブレークポイントを最後のキャッシュ可能なブロックに自動で付け、会話が伸びるにつれて先へ動かす、と説明されています。
1時間の TTL にする場合は、"ttl": "1h" を足します。TTL を混ぜるときは、長い TTL のブロックを短い TTL より前に置く必要があります。最後のブロックに別の TTL を明示した状態で自動キャッシュを使うと、400 エラーになります。
最小トークン数はモデルによって違います。公式の表では、Claude Sonnet 5.5、Opus 5.5、Haiku 5.5 などは512、Claude Sonnet 4.6 などは1,024、Claude Opus 4.5 と Haiku 4.5 は4,096です。使うモデルの値を表で確認してください。
効果が出る設計:固定を前に、可変を後ろに
キャッシュは先頭からの一致で決まるので、設計の原則は単純です。変わらないものを前に、変わるものを後ろに置きます。
- 先頭に置くのは、ツール定義、システムプロンプト、固定の参考資料です。
- 次に、更新頻度の低い文脈(社内ルール、仕様書、コードベースの要約)を置きます。
- 最後に、ユーザーの質問や、その回だけの情報を置きます。
避けたいのは、先頭近くに変わる値を入れることです。現在時刻やリクエスト ID をシステムプロンプトの冒頭に差し込むと、毎回前置きが変わり、後ろのキャッシュがすべて外れます。そうした値は末尾のユーザーメッセージ側に回します。
ブレークポイントは、更新頻度が違う境目に置きます。「システム」「固定資料」「会話履歴」の3か所に置けば、会話履歴だけが変わっても前の2つは再利用されます。
キャッシュが外れる原因
公式ドキュメントによると、変更した階層とそれより後ろの階層のキャッシュが無効になります(順序は tools、system、messages)。主な例は次のとおりです。
- ツール定義(名前、説明、パラメータ)の変更:tools、system、messages のすべてが無効になります。
- Web 検索や引用機能の切り替え:system と messages が無効になります。
tool_choiceの変更、画像の追加・削除:messages が無効になります。- 思考(thinking)の設定や
effortの変更:影響はモデルによって異なります。
そのほかに、よくある原因は次の4つです。
- 前置きが最小トークン数に届いていない。
- TTL が切れた。5分以上あくと、再び書き込みになります。
- 前置きに、時刻やランダム値が混ざっている。
- ブレークポイントの位置から、さかのぼって一致を探す範囲を超えた。公式ドキュメントでは、各ブレークポイントで確認する位置は最大20です。会話が一度に大きく伸びたときは、ブレークポイントを足します。
効いているか確認する方法
レスポンスの usage を見ます。公式ドキュメントの例は次の形です。
"usage": {
  "input_tokens": 2048,
  "cache_read_input_tokens": 1800,
  "cache_creation_input_tokens": 248,
  "output_tokens": 503
}
| 項目 | 意味 |
|---|---|
cache_read_input_tokens |
キャッシュから読み出したトークン数 |
cache_creation_input_tokens |
キャッシュに書き込んだトークン数 |
input_tokens |
最後のブレークポイントより後ろの、キャッシュ対象外のトークン数 |
入力の合計は、この3つの和です。input_tokens が小さいのは、キャッシュが効いている状態です。cache_read_input_tokens と cache_creation_input_tokens がどちらも0なら、キャッシュされていません。最小トークン数、前置きの変動、ブレークポイントの位置の順に疑います。
運用では、ヒット率(読み取り ÷ 入力の合計)をログに残すと、変更の効果を比べられます。
公式ドキュメントには、キャッシュヒットはレート制限の対象から差し引かれない、という趣旨の記述があります。レート制限に当たりやすい構成では、料金以外の面でも効きます。適用の細かい条件は、自分のプランの説明で確認してください。
他社との違い
| 項目 | Anthropic | OpenAI | Google(Gemini) |
|---|---|---|---|
| 指定方法 | cache_control を自分で付ける(自動指定も可) |
対応モデルで既定で有効(暗黙)。GPT-5.6 以降は明示指定も選べる | 暗黙のキャッシュが既定で有効。明示キャッシュは一部のモデル・API で利用 |
| 最小トークン数 | モデルにより512〜4,096 | GPT-5.6 以降は1,024 | 掲載モデルで2,048または4,096 |
| 有効時間 | 5分または1時間 | 旧モデルは in_memory または 24h、GPT-5.6 以降は30分または12時間 |
確認できず |
| 使用量の確認 | cache_read_input_tokens など |
usage.input_tokens_details.cached_tokens |
usage.total_cached_tokens |
OpenAI の公式ドキュメントでは、キャッシュされた入力トークンの割引は「最大95%」とされています。旧モデルでは prompt_cache_key で関連するリクエストを同じキャッシュに寄せられますが、命中を保証するものではありません。
Gemini の公式ドキュメントは、「キャッシュにヒットした場合、節約分を自動的に反映する」と説明しています。割引率と明示キャッシュの保管料金、既定の TTL は、確認したページには書かれていませんでした。この記事では数値を載せません。
共通点は、前置きの一致が条件で、固定部分を先頭に置く設計が有効なことです。Anthropic は、位置と有効時間を自分で指定できます。OpenAI と Google は、既定で暗黙のキャッシュが働きます。モデルごとに仕様が変わるので、実装前に公式の最新版を確認してください。
まとめ:実装の要点
- Claude API では、
cache_controlを付けたブロックまでの前置きが完全に一致したときに、キャッシュが読み出されます。 - 固定のもの(ツール、システムプロンプト、固定資料)を先頭に、変わるものを末尾に置きます。時刻などの変動値は先頭に入れません。
- 書き込みは基本料金の1.25倍(5分)または2倍(1時間)、読み取りは基本の0.1倍が標準で、モデルによって異なります。
- 最小トークン数に届かないと、エラーなしでキャッシュされません。
- 効果は
usageのcache_read_input_tokensで確認し、ヒット率をログに残します。 - 他社も前置きの一致が基本です。指定方法、最小トークン数、有効時間は違います。
用語は、コンテキストウィンドウとトークン課金の項も参照してください。
出典
- Prompt cachingAnthropic
- Prompt cachingOpenAI
- Context cachingGoogle
この記事で扱った企業
この記事で扱ったモデル
- Claude Sonnet 5.5Anthropic
- Claude Opus 5.5Anthropic
- Claude Haiku 5.5Anthropic
あわせて読みたい
用途と費用で選ぶ、テキスト生成 AI モデルの選び方(2026年11月版)
Claude、GPT、Gemini の新世代がそろい、同じ価格帯に各社のモデルが並ぶようになりました。この記事では、公式の料金表をもとに価格帯ごとの選択肢を整理し、用途から候補をしぼる手順を説明します。
ニュース
Anthropic、Claude Haiku 5.5 を公開 Claude 5.5 ファミリーがそろう
Anthropic は10月7日、小型モデル Claude Haiku 5.5 を公開しました。9月の Opus 5.5、Sonnet 5.5 に続くもので、これで Claude 5.5 ファミリーの3モデルがそろいました。10万トークン以下の入力では、入力100万トークンあたり $0.10 と大幅に安くなっています。
ニュース
Anthropic、Claude Opus 5.5 を公開 Fable 5.1 に近い性能で料金は Opus 5 より安く
Anthropic は9月22日、Claude 5.5 ファミリーの最初のモデル Claude Opus 5.5 を公開しました。多くの作業で Claude Fable 5.1 と同等の水準としつつ、料金は Opus 5 より下げています。拡張思考は常に有効になりました。